Décision
Trop volumineux
Les outils classiques ralentissent-ils ?
Impact décision : Le stockage et les traitements doivent changer.


Une PME peut accumuler des ventes, des tickets support, des logs web, des fichiers clients et des données d’outils métier sans faire réellement du Big Data. Le sujet commence quand ces informations deviennent trop nombreuses, trop rapides, trop variées ou trop difficiles à relier avec les outils habituels, mais aussi quand leur lecture demande une méthode commune entre les équipes métier, techniques et direction.
Dit simplement, le Big Data désigne des ensembles de données dont la taille, la vitesse, la diversité ou la complexité imposent de nouvelles méthodes de stockage, de traitement et d’analyse. L’objectif n’est pas de collectionner plus de données. L’objectif est de produire une meilleure décision.
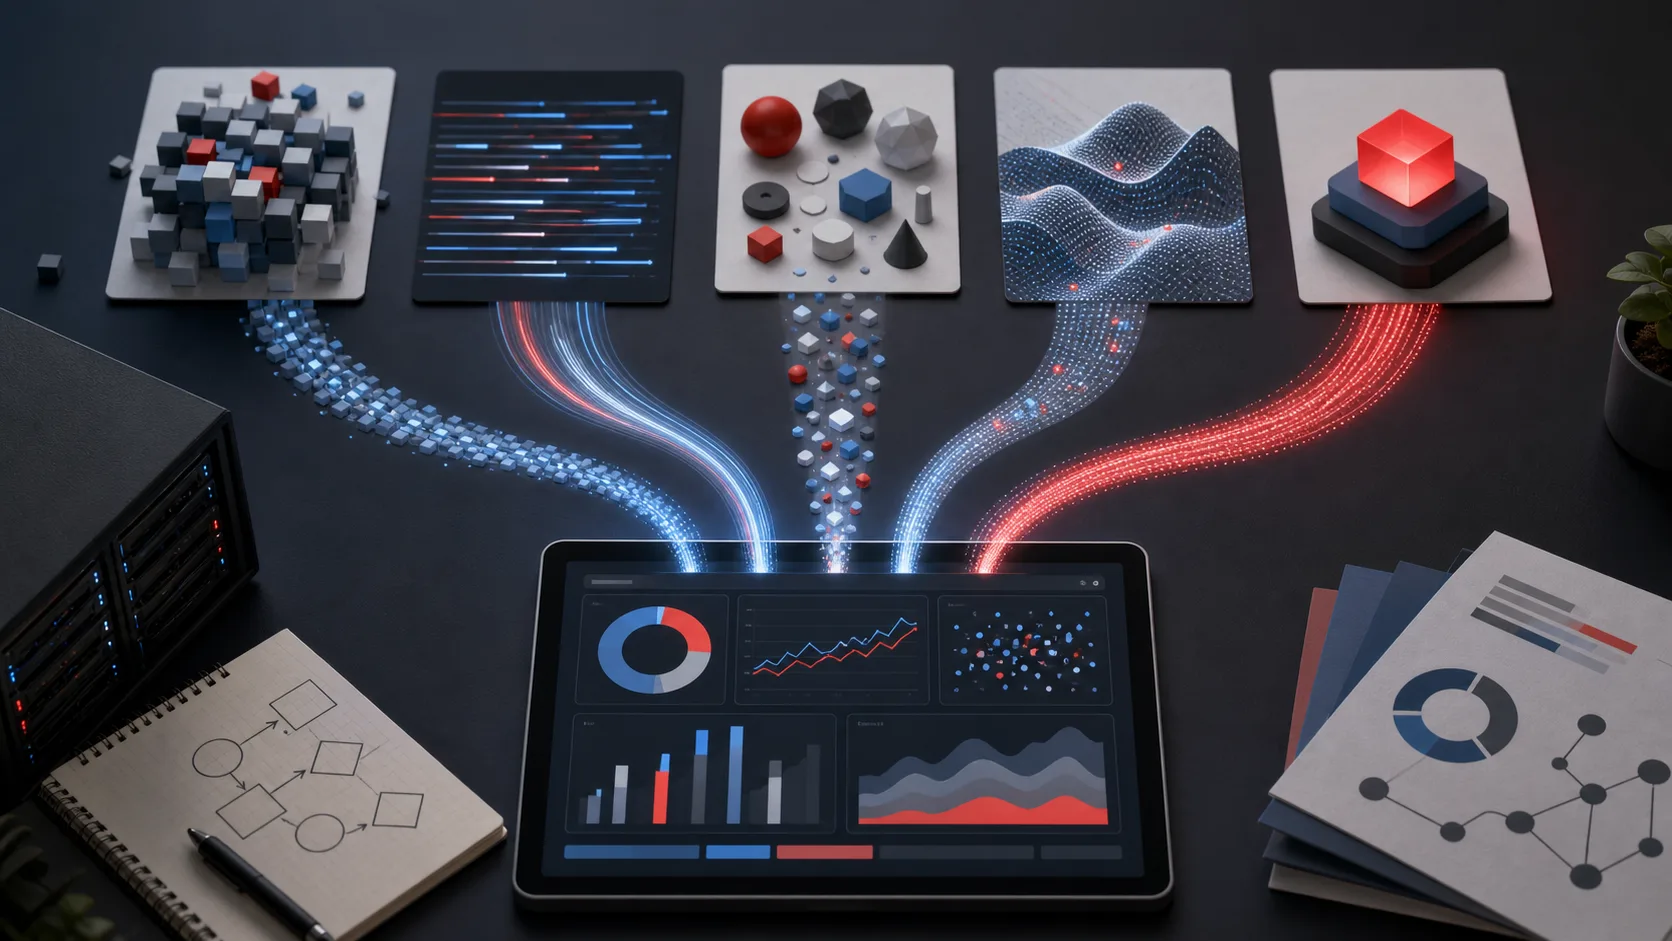
La nuance est importante, surtout pour une PME qui débute en data. Le Big Data ne veut pas seulement dire “beaucoup de données”. Un fichier client très lourd peut rester gérable dans une base classique. À l’inverse, des flux de navigation, des transactions, des messages, des images ou des logs techniques peuvent devenir difficiles à exploiter s’ils arrivent en continu et sous des formats différents, avec des règles de lecture qui changent selon la source.
La définition pratique tient en une idée : il faut une architecture adaptée pour transformer les données en action.
La bonne porte d’entrée reste la question métier. Que veut-on mieux comprendre ? Une baisse de conversion, une panne récurrente, un comportement client, une fraude, une demande de support, un niveau de stock ? Sans question claire, la masse de données devient un entrepôt coûteux.
| Terme | Ce que cela signifie | Erreur fréquente |
|---|---|---|
| Donnée brute | Information collectée mais pas encore utile | La garder sans contexte |
| Donnée exploitable | Donnée fiable, reliée à un usage | La confondre avec un simple fichier volumineux |
| Analyse | Traitement qui révèle un signal | Produire des graphiques sans décision |
| Valeur | Décision améliorée, risque réduit ou action plus rapide | Mesurer seulement le volume stocké |
Le modèle des 5V reste utile parce qu’il évite de réduire le sujet à la taille des fichiers. Le volume correspond à la quantité. La vélocité désigne la vitesse d’arrivée ou de traitement. La variété couvre les formats : texte, images, logs, transactions, capteurs, audio, événements. Dans un projet réel, ces trois premiers critères servent surtout à dimensionner l’effort technique avant de promettre une analyse avancée, puis à expliquer simplement pourquoi un tableur ou une base isolée ne suffit plus.
Les deux derniers V sont souvent les plus négligés. La véracité mesure la fiabilité : doublons, erreurs, données obsolètes, sources contradictoires. La valeur rappelle que le projet doit servir une décision. Une donnée rapide et massive ne vaut pas grand-chose si elle pousse à agir sur un signal faux, et c’est précisément ce point qui sépare une démarche data utile d’une simple accumulation technique.
Dans une PME, le problème n’est pas toujours le volume. Il peut venir de la variété et de la véracité : CRM incomplet, exports e-commerce, fichiers comptables, analytics, tickets support et tableurs qui ne parlent pas la même langue. C’est souvent là que la dette data apparaît.
Ces critères aident à distinguer un vrai sujet Big Data d’un simple problème de rangement.
Les outils classiques ralentissent-ils ?
Impact décision : Le stockage et les traitements doivent changer.
Les données arrivent-elles en continu ?
Impact décision : La décision doit parfois se prendre en quasi temps réel.
Les formats sont-ils difficiles à relier ?
Impact décision : Le nettoyage et la modélisation deviennent centraux.
La donnée est-elle fiable ?
Impact décision : Une mauvaise donnée produit une mauvaise décision.
Le meilleur usage est celui qui modifie une décision réelle. Le Big Data sert d’abord à voir des signaux que l’on ne verrait pas à petite échelle : une tendance de vente, un comportement utilisateur, une anomalie technique ou un risque de départ client peut rester invisible dans un rapport mensuel classique, puis devenir beaucoup plus clair quand les données sont rapprochées avec méthode et reliées à un objectif opérationnel précis.
Les usages les plus solides sont souvent très concrets : prévoir la demande, détecter une fraude, prioriser des tickets support, optimiser un stock, personnaliser une recommandation, surveiller une infrastructure ou améliorer une campagne marketing. Le cas d’usage doit être formulé en une phrase simple, avec un responsable identifié et un changement attendu dans la façon de travailler.
La promesse devient dangereuse quand elle reste vague. “Exploiter toutes nos données” n’est pas un projet. “Réduire les ruptures de stock en croisant ventes, saisonnalité et délais fournisseurs” en est un. Cette précision permet de choisir les données, les outils et le niveau d’investissement.
Ces notions se recoupent. Elles ne répondent pourtant pas à la même question métier ni au même niveau de maturité.
Retrouvez aussi statuts juridiques pour examiner les statuts juridiques fixent les règles de l’entreprise séparément.
La data analytics désigne l’analyse des données pour comprendre une situation ou guider une décision. Le Big Data décrit surtout une difficulté d’échelle, de vitesse ou de variété. L’intelligence artificielle, elle, peut utiliser ces données pour prédire, classer, recommander ou automatiser certaines tâches, à condition que le socle de données soit assez stable pour que le modèle ne reproduise pas les erreurs du système.
Ces trois sujets se croisent, mais ils ne sont pas interchangeables. Une entreprise peut faire de très bonnes analyses sans Big Data. Elle peut aussi déployer une IA faible si ses données sont mal préparées. La qualité du socle compte plus que l’étiquette technologique.
Un projet raisonnable avance par paliers : comprendre les données existantes, corriger les sources, définir les indicateurs, automatiser les flux, puis seulement tester des modèles plus avancés. La technologie accélère un système clair ; elle ne sauve pas un système confus. Cette progression protège le budget, mais aussi la crédibilité du projet auprès des équipes qui devront utiliser les résultats au quotidien, surtout lorsque les premiers arbitrages touchent les stocks, les priorités commerciales ou la relation client.
La première limite est la qualité. Si les sources sont incomplètes, mal nommées ou contradictoires, l’analyse sera fragile. Beaucoup de projets Big Data échouent moins par manque de puissance technique que par manque de définition : données mal gouvernées, responsables flous, indicateurs instables. C’est aussi pour cela qu’un projet modeste, mais bien documenté, peut produire plus de valeur qu’un dispositif ambitieux construit sur des bases incertaines et impossible à expliquer simplement aux équipes.
La deuxième limite est le coût. Il ne se résume jamais à l’abonnement logiciel.
La troisième limite concerne la confidentialité et la sécurité. Plus les données sont nombreuses et croisées, plus le risque augmente : accès trop larges, données personnelles conservées inutilement, fuite, biais, mauvaise interprétation. Un projet sérieux intègre la gouvernance data dès le départ.
Les mauvais départs se ressemblent beaucoup : la première erreur consiste à confondre ambition et périmètre. Une direction peut vouloir connecter toutes les sources, tout historiser et tout analyser dès le premier chantier. Sur le papier, l’idée paraît rationnelle. Dans la pratique, elle crée souvent un tunnel technique sans résultat métier visible pendant des mois, ce qui finit par fatiguer les équipes avant même le premier apprentissage exploitable ou le premier gain mesurable.
La deuxième erreur est de choisir l’outil avant le problème. Le bon ordre reste simple : usage, sources, qualité, architecture, puis outil.
Attention aussi aux indicateurs décoratifs. Un rapport peut être beau, dynamique et partagé à toute l’entreprise sans aider personne à agir. Si une métrique ne déclenche aucune décision, aucune alerte ou aucune discussion utile, elle occupe de la place mais ne crée pas de valeur opérationnelle.
Enfin, beaucoup de projets sous-estiment le travail humain. Les métiers doivent expliquer les règles, les exceptions, les périodes atypiques, les changements de nomenclature et les biais connus. Sans cette lecture terrain, le signal exploitable se mélange vite avec du bruit statistique.
Le bon socle reste simple. Il doit surtout être lisible, contrôlable et accepté par les équipes qui l’utilisent.
Une architecture Big Data peut devenir très complexe, mais son principe reste lisible. Il faut d’abord collecter les données depuis les outils sources, puis les stocker dans un espace adapté, les nettoyer, les transformer, les analyser et enfin les restituer dans des rapports, alertes ou modèles utilisables.
Pour une PME, l’enjeu n’est pas forcément de construire une infrastructure impressionnante. L’enjeu est de créer un flux fiable entre les sources importantes et les décisions. Une extraction quotidienne bien contrôlée peut parfois suffire là où un flux temps réel coûterait cher sans apporter de gain concret.
Le stockage doit être pensé selon l’usage. Les données brutes gardent une trace utile, mais les données préparées doivent être compréhensibles par les équipes. Si seuls deux profils techniques peuvent expliquer un indicateur, le système reste fragile. La donnée fiable doit pouvoir être vérifiée, documentée et discutée.
| Étape | Question à poser | Décision pratique |
|---|---|---|
| Collecte | Quelles sources alimentent le cas d’usage ? | Limiter le périmètre aux données nécessaires. |
| Stockage | Faut-il garder brut, préparé ou les deux ? | Prévoir une traçabilité sans tout exposer. |
| Traitement | À quelle fréquence la donnée doit-elle être mise à jour ? | Choisir batch quotidien, horaire ou temps réel selon le besoin. |
| Restitution | Qui agit après lecture du résultat ? | Construire une vue par décision, pas par curiosité. |
Un projet Big Data ne doit pas être évalué seulement avec des indicateurs techniques. Le volume traité, le temps de calcul ou le nombre de sources connectées peuvent être utiles, mais ils ne prouvent pas que l’entreprise décide mieux. Il faut aussi mesurer l’impact métier, la fréquence d’utilisation des résultats, la capacité des équipes à expliquer une décision à partir du même chiffre et la baisse des retraitements manuels qui ralentissaient les décisions avant le projet.
Les bons indicateurs dépendent du cas d’usage. Pour un stock, on regardera les ruptures évitées, les surstocks réduits et la précision des prévisions. Pour le support, on suivra la baisse des tickets répétitifs, le délai de résolution et la qualité des réponses. Pour le marketing, on vérifiera si les segments améliorent vraiment la conversion, sans oublier les effets de bord : pression commerciale excessive, recommandations mal ciblées ou indicateurs devenus trop complexes pour être utilisés.
Un autre signal important est la confiance interne. Quand les équipes cessent de retraiter les chiffres dans des tableurs parallèles, c’est souvent que le socle data devient crédible. À l’inverse, si chacun corrige encore les exports à la main avant chaque réunion, le projet n’a pas fini son travail de base.
Le pilotage doit aussi intégrer les coûts. Une analyse qui fait gagner deux heures par mois mais mobilise une infrastructure chère, des consultants permanents et une maintenance lourde n’est pas forcément rentable. La bonne question n’est pas “peut-on le faire ?”, mais “le gain justifie-t-il le coût complet ?”
Il faut enfin mesurer l’adoption. Un tableau de bord consulté par une seule personne ne transforme pas l’organisation. La donnée devient utile quand elle entre dans un rituel concret : revue hebdomadaire, alerte de seuil, arbitrage de stock, priorisation commerciale ou correction d’un parcours client. Ce rituel donne un usage réel aux chiffres.
La confidentialité doit entrer dans le projet avant les premiers croisements sensibles. Plus une entreprise croise ses données, plus elle peut révéler des informations sensibles. Des données commerciales, comportementales ou RH peuvent paraître anodines séparément, puis devenir très précises une fois reliées. C’est pourquoi les accès, la conservation et l’anonymisation doivent être pensés dès le cadrage, avant que les tableaux de bord ne circulent trop largement et que les exports ne se multiplient sans contrôle.
Le principe pragmatique consiste à ne collecter que ce qui sert vraiment le cas d’usage. Garder “au cas où” semble rassurant, mais cela augmente la surface de risque, les coûts et la complexité. Les droits d’accès doivent être limités, traçables et régulièrement revus, avec une différence nette entre lecture, export, modification et suppression des données.
La confidentialité n’est pas seulement un sujet juridique. Elle conditionne aussi l’acceptation interne du projet. Si les équipes ont l’impression que l’analyse sert à surveiller sans cadre clair, elles contourneront les outils ou retiendront des informations. Un projet data durable explique donc ce qui est mesuré, pourquoi, avec quelles limites et comment les résultats seront utilisés dans les décisions collectives.
Le bon démarrage est volontairement étroit. Il prouve la valeur avant d’élargir l’infrastructure ou de connecter de nouvelles sources.
Pour une PME, le bon départ consiste rarement à acheter une plateforme lourde. Commencez par une cartographie des données existantes : où sont-elles, qui les produit, qui les utilise, à quelle fréquence, avec quel niveau de fiabilité ? Cette étape paraît basique, mais elle révèle souvent les vrais blocages.
Ensuite, choisissez un cas d’usage court. Par exemple : réduire les demandes support répétitives, mieux prévoir les ventes, comprendre les abandons de panier ou détecter les anomalies de facturation. Un périmètre limité permet de tester la chaîne de valeur complète : collecte, nettoyage, analyse, décision, action.
Le meilleur indicateur de maturité n’est pas le nombre de téraoctets stockés. C’est la capacité à répondre vite à une question fiable. Si chaque réunion commence par “d’où vient ce chiffre ?”, le chantier prioritaire n’est pas le Big Data. C’est la confiance dans la donnée.
Ne commencez pas par “faire du Big Data”. Commencez par une décision mal éclairée aujourd’hui : prévision, support, stock, marketing, risque, infrastructure. Si les données nécessaires existent mais sont dispersées, le projet a du sens. Si elles n’existent pas ou ne sont pas fiables, il faut d’abord corriger la base, documenter les règles et accepter qu’un bon chantier data commence souvent par du nettoyage très concret.
La priorité est claire : construire un petit système fiable plutôt qu’un grand système spectaculaire. Un tableau de bord juste, alimenté proprement et utilisé chaque semaine vaut mieux qu’une plateforme massive que personne ne comprend. La valeur métier doit rester le critère de décision.
Le Big Data devient utile quand il réduit une incertitude, accélère une action ou révèle un signal exploitable. S’il ne change aucune décision, ce n’est pas un levier stratégique : c’est simplement du stockage plus cher.

À lire aussi

Le Firestick TV stick transforme n'importe quel écran en plateforme de divertissement. Pour en tirer le meilleur, vous avez [ ]
· ·13 min 
Le guide clair pour partager une connexion internet avec un PC, une tablette ou une console : méthode, sécurité, data et dépannage.
 · ·8 min

La qualité d'une navigation en ligne ne se devine pas ; elle se mesure. Pourtant, beaucoup hésitent encore à lancer un [ ]
· ·15 min 
Voici comment couper l'overlay Discord globalement ou par jeu, vérifier le raccourci et corriger les conflits qui gênent les FPS ou l'affichage.
· ·5 min 
Microsoft Intune devient utile quand le déploiement est cadré. Voici une méthode progressive pour sécuriser les appareils sans casser le quotidien des équipes.
· ·11 min 
Un message d'absence Teams utile ne se limite pas à un statut : il doit indiquer la période, le relais, l'urgence et rester cohérent avec Outlook.
· ·12 min Un recap net, des sorties a surveiller et nos meilleurs debriefs sans spam.
Aucun spam. Désinscription en un clic.
