Accès
Authentification
Les tickets ou jetons expirent-ils trop tôt ?
Impact décision : Une dérive peut provoquer des refus de connexion ou des sessions incohérentes.


Le protocole NTP ne se voit presque jamais, jusqu'au jour où l'heure dérape. Un serveur avance de cinq minutes, un certificat devient invalide, une session refuse de s'ouvrir, un journal d'événements classe les actions dans le désordre et l'enquête technique commence sur une base fausse. Dans une infrastructure moderne, l'heure système n'est pas un détail d'affichage : c'est une donnée de confiance.
NTP, pour Network Time Protocol, synchronise les horloges des machines avec des sources de temps de référence. Il agit en arrière-plan sur les serveurs, postes, équipements réseau, hyperviseurs, appliances et parfois les plateformes de jeu ou de streaming. Son rôle est simple à formuler, mais exigeant à exploiter : maintenir une chronologie commune malgré la latence réseau, les horloges matérielles imparfaites et les incidents de configuration.
NTP permet à une machine cliente de demander l'heure à un ou plusieurs serveurs de temps, puis d'ajuster son horloge locale. Le protocole utilise généralement UDP sur le port 123, ce qui limite le poids des échanges. Il ne se contente pas de recopier une heure reçue : il estime aussi le délai aller-retour et l'écart entre les deux horloges.
Cette nuance est importante. Sur un réseau, un paquet ne voyage jamais instantanément. Le client doit donc calculer le décalage probable entre son horloge et celle du serveur, tout en tenant compte de la latence. Les implémentations modernes évitent les corrections brutales quand c'est possible : elles font glisser l'horloge progressivement afin de ne pas perturber les applications.
Le protocole existe depuis les débuts d'Internet. La première spécification historique remonte à la RFC 958, puis NTPv4 a été formalisé par la RFC 5905. Cette longévité explique sa présence massive, mais aussi un piège : beaucoup d'équipes l'oublient parce qu'il fonctionne depuis des années sans bruit apparent.
Une dérive de quelques secondes peut sembler acceptable sur un poste isolé. Elle devient problématique dès qu'un système dialogue avec d'autres systèmes. Les certificats TLS reposent sur des dates de validité. Les jetons d'authentification expirent selon une fenêtre temporelle. Les sauvegardes, les déploiements et les tâches planifiées s'appuient sur des repères horaires cohérents.
Les journaux d'événements sont souvent la première victime visible. Si un contrôleur de domaine, une application, un pare-feu et une base de données n'ont pas la même heure, reconstituer un incident devient incertain. Une connexion paraît précéder la requête qui l'a déclenchée. Un blocage semble arriver après la résolution. L'équipe perd la ligne de temps, donc une partie de sa capacité d'analyse.
Dans le jeu en ligne, les plateformes communautaires ou les services temps réel, la cohérence temporelle sert aussi à classer des événements, limiter certains abus, gérer des sessions et rapprocher des traces côté serveur. NTP ne remplace pas une logique applicative robuste, mais il donne au système un socle temporel stable.
Les symptômes apparaissent souvent ailleurs que dans le service de temps lui-même.
Les tickets ou jetons expirent-ils trop tôt ?
Impact décision : Une dérive peut provoquer des refus de connexion ou des sessions incohérentes.
La machine voit-elle le certificat comme valide ?
Impact décision : Une mauvaise date peut rendre un certificat valide apparemment expiré ou prématuré.
Les événements sont-ils comparables entre systèmes ?
Impact décision : Sans ordre fiable, l’analyse d’incident devient fragile.
Sauvegardes et scripts se lancent-ils au bon moment ?
Impact décision : Les automatismes métiers dépendent d’une heure stable.
Le vocabulaire NTP parle de strates. Une source de référence directe, comme une horloge atomique ou GPS, est assimilée à une référence de strate 0. Un serveur connecté à cette source devient généralement stratum 1. Les serveurs qui se synchronisent sur lui passent en stratum 2, puis ainsi de suite.
La strate mesure donc une distance logique avec la référence, pas une promesse de qualité parfaite. Un serveur stratum 2 bien maintenu, proche, stable et redondant peut être plus utile qu'un stratum 1 saturé ou mal joignable. Le bon choix tient compte de la stabilité, la latence, la redondance et la confiance, pas seulement du chiffre affiché.
Il faut aussi éviter que chaque poste interroge directement des serveurs publics prestigieux. Dans une organisation, mieux vaut souvent désigner quelques serveurs internes ou relais contrôlés, puis faire pointer les clients vers eux. Cette approche réduit la charge externe et donne une meilleure maîtrise de la politique de temps.
Pour approfondir ce point, consultez Heure livraison Colissimo : Horaires et astuces, qui traite plus précisément de heure livraison colissimo : horaires et astuces.
Un client NTP envoie une requête horodatée, reçoit une réponse horodatée, puis compare plusieurs instants : départ, réception serveur, émission serveur, retour client. À partir de ces valeurs, il estime l'offset, c'est-à-dire l'écart à corriger, et le délai réseau. Les algorithmes filtrent ensuite les réponses incohérentes ou trop variables.
Quand l'écart est faible, le service ralentit ou accélère légèrement l'horloge au lieu de la sauter. Ce comportement évite de casser les applications sensibles à une heure qui recule. Quand l'écart est énorme, notamment au démarrage d'une machine longtemps arrêtée, une correction plus franche peut être nécessaire, mais elle doit rester maîtrisée.
La vraie question d'exploitation n'est donc pas seulement “le service NTP tourne-t-il ?”. Il faut savoir si la machine est synchronisée, sur quelle source, avec quelle dérive et depuis combien de temps. C'est la différence entre un service actif et un temps fiable.
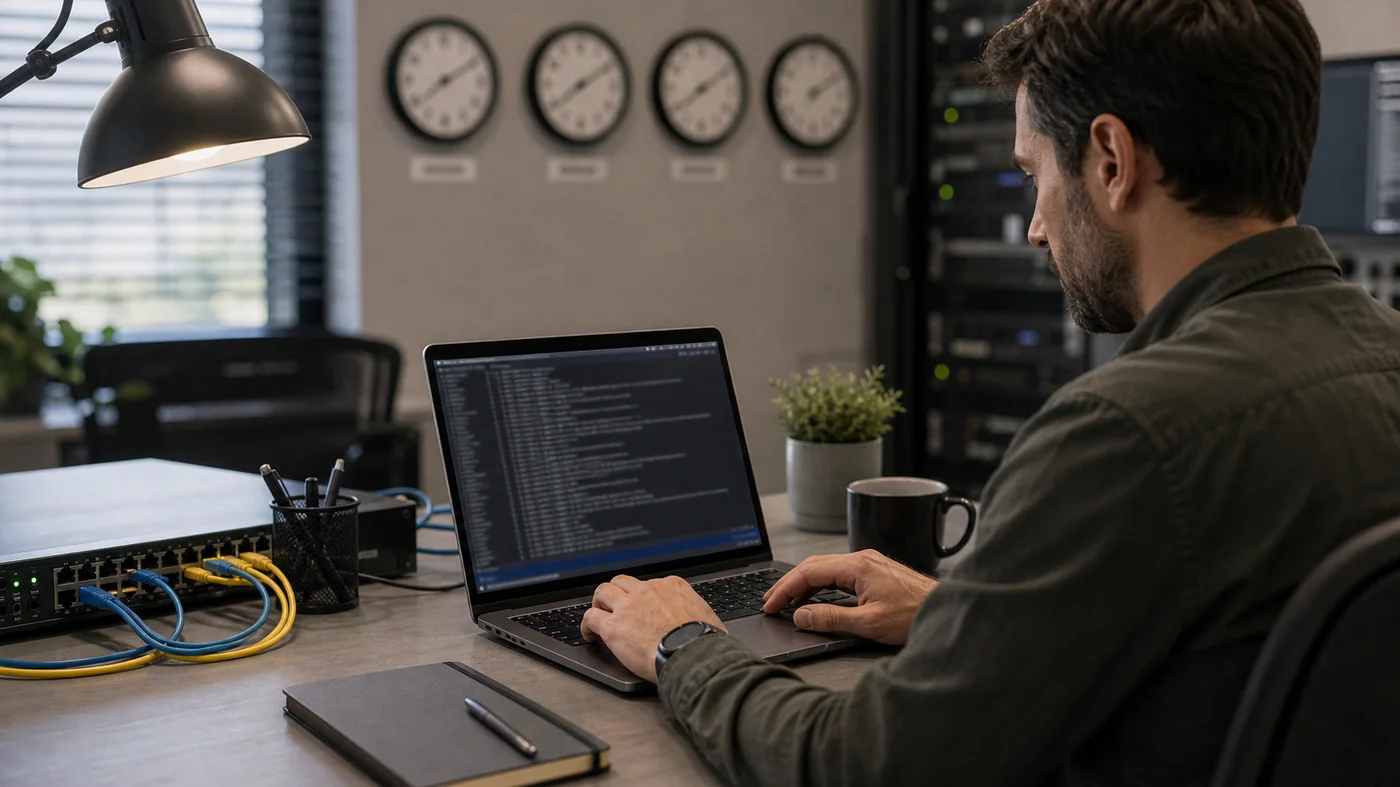
Pour un poste personnel, les réglages par défaut du système suffisent souvent. Pour une infrastructure, il faut choisir volontairement les sources. Une configuration saine utilise plusieurs serveurs, idéalement trois ou quatre sources, afin de détecter une réponse aberrante et de continuer à fonctionner si l'une tombe.
Le projet NTP Pool fournit des serveurs publics répartis géographiquement. C'est une solution pratique pour de nombreux usages, à condition de respecter les recommandations du projet et de ne pas pointer une flotte entière sans relais interne. Les environnements cloud, les systèmes Windows d'entreprise, les distributions Linux et les équipements réseau peuvent aussi proposer des sources adaptées à leur écosystème.
Dans une entreprise, le bon schéma dépend du risque. Une petite infrastructure peut utiliser des sources publiques fiables. Un système industriel, financier, d'hébergement ou d'authentification centralisée préférera des relais internes, supervisés, documentés et protégés par pare-feu. L'objectif n'est pas la sophistication, mais la maîtrise de la dépendance.
La première erreur consiste à utiliser une seule source. Si elle répond mal, si elle change, si elle devient inaccessible ou si le réseau la filtre, toute la chaîne temporelle devient fragile. Un serveur unique donne une apparence de simplicité, mais il supprime la comparaison entre sources.
La deuxième erreur consiste à exposer inutilement un serveur NTP sur Internet. Historiquement, des serveurs mal configurés ont servi à des attaques par amplification. Un relais interne doit répondre aux clients prévus, pas au monde entier. Les règles réseau doivent préciser qui peut interroger qui.
La troisième erreur est documentaire. Personne ne sait quelle source est utilisée, qui l'administre, quelle commande permet de vérifier l'état et quelle dérive déclenche une alerte. Le jour où l'authentification tombe, l'équipe découvre que le plan de temps n'existe que dans la mémoire d'un ancien administrateur.
Sur Linux, l'outil dépend de la distribution et du choix technique. Beaucoup d'environnements modernes utilisent chrony, d'autres systemd-timesyncd ou encore ntpd. Des commandes comme timedatectl, chronyc tracking, chronyc sources ou ntpq -p permettent d'observer la source active, la dérive et l'état de synchronisation.
Sur Windows, le service Windows Time se vérifie notamment avec w32tm /query /status ou w32tm /query /source. Dans un domaine Active Directory, la hiérarchie temporelle suit des règles propres : les postes se synchronisent avec le domaine, et l'émulateur PDC joue un rôle central. Une erreur de temps peut alors toucher l'authentification Kerberos.
Les équipements réseau ne doivent pas être oubliés. Routeurs, pare-feux, switches managés, appliances de sécurité et solutions de supervision produisent des logs essentiels. S'ils n'ont pas la même heure que les serveurs, les corrélations deviennent imprécises, surtout pendant une attaque ou une panne multi-équipement.
Retrouvez aussi The Conjuring pour examiner pourquoi the conjuring reste une référence de l’horreur moderne séparément.
Un service temps fiable doit être surveillé comme un service d'infrastructure. Les alertes peuvent rester simples : source inaccessible, dérive trop élevée, changement de source inattendu, offset au-dessus d'un seuil, serveur non synchronisé, port filtré ou écart soudain après redémarrage.
Le seuil dépend du contexte. Pour un poste bureautique, quelques secondes peuvent déjà suffire à créer des irritants. Pour une authentification centralisée, des certificats, des transactions ou des traces de sécurité, il faut une marge plus stricte. Le plus important est d'avoir un seuil critique décidé avant l'incident.
La supervision doit aussi conserver l'historique. Une dérive lente révèle parfois une source instable, une VM mal configurée, une pile réseau filtrée ou un hyperviseur qui impose sa propre logique. Sans historique, l'équipe ne voit qu'un état instantané et manque la tendance temporelle.
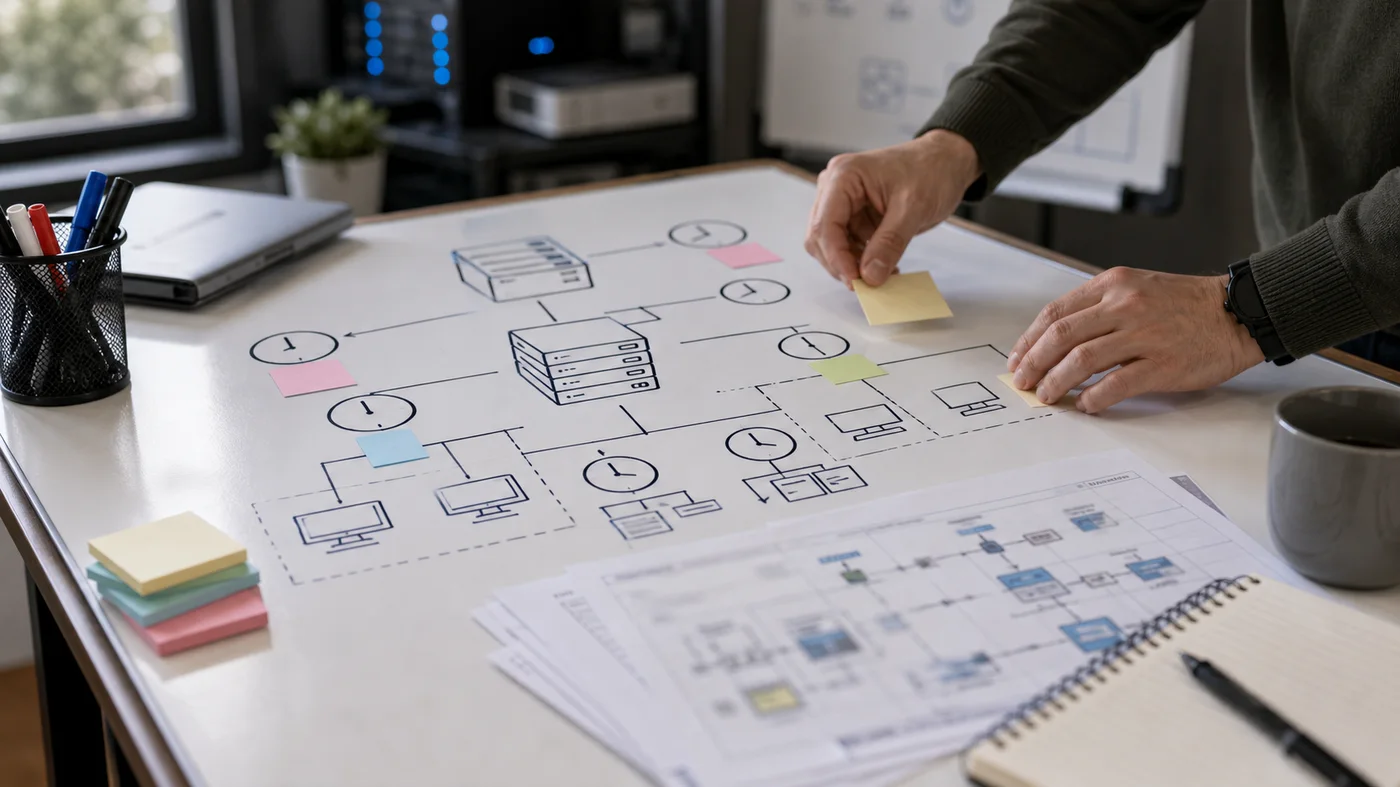
Commencez par l'inventaire : contrôleurs de domaine, serveurs applicatifs, bases de données, hyperviseurs, appliances, équipements réseau, systèmes de sauvegarde, postes critiques et plateformes externes. Notez pour chacun la source de temps attendue, la commande de contrôle et le responsable. Ce tableau devient la carte de synchronisation.
Définissez ensuite la hiérarchie. Les clients interrogent des relais internes quand c'est pertinent. Les relais interrogent plusieurs sources externes ou spécialisées. Les exceptions sont justifiées : environnement isolé, site distant, cloud, équipement industriel ou contrainte fournisseur. Cette hiérarchie doit être simple, sinon elle ne sera pas maintenue.
Enfin, testez le plan. Coupez une source, observez le basculement. Redémarrez un serveur, vérifiez sa resynchronisation. Contrôlez les règles pare-feu. Comparez les logs entre deux systèmes. Une configuration NTP validée n'est pas seulement écrite : elle produit des preuves de fonctionnement.
NTP stabilise l'horloge de l'OS, mais il ne résout pas tous les problèmes de temps dans les applications. Une base de données, une file de messages, un moteur de jeu ou une plateforme distribuée peut avoir sa propre façon d'ordonner les événements. Les développeurs doivent rester prudents avec les timestamps locaux, les fuseaux horaires et les changements d'heure.
La bonne pratique consiste à stocker les instants dans un format cohérent, souvent UTC, puis à convertir seulement à l'affichage. Les logs, métriques et événements doivent expliciter leur fuseau ou leur format. NTP fournit une base, mais l'application doit encore gérer la représentation du temps.
Cette distinction évite de surpromettre. Une infrastructure bien synchronisée ne corrige pas un bug de tri, une conversion locale ratée ou une règle métier ambiguë. Elle enlève en revanche une cause majeure de confusion et rend les diagnostics beaucoup plus fiables.
À utiliser lors d’un audit rapide ou après un incident de temps.
NTP n'a pas besoin d'être spectaculaire. La plupart des infrastructures veulent une heure stable, traçable et suffisamment précise pour leurs usages. La rigueur consiste à choisir des sources crédibles, éviter les expositions inutiles, vérifier régulièrement l'état et savoir quoi faire quand l'offset dépasse la limite.
Plus l'environnement est sensible, plus la discipline compte : authentification, supervision, sécurité, finance, exploitation de serveurs, plateformes communautaires et services temps réel. Dans ces cas, une minute d'écart peut produire des effets disproportionnés.
Le protocole NTP protège vos systèmes parce qu'il protège leur chronologie. Quand les machines partagent le même temps, les événements se comprennent mieux, les accès se vérifient plus proprement et les incidents se reconstruisent avec moins d'incertitude. C'est discret, mais c'est exactement le type de fondation qu'une infrastructure saine doit traiter sérieusement.
Pour approfondir ce point, consultez Découvrez pourquoi le xtream player révolutionne votre, qui traite plus précisément de découvrez pourquoi le xtream player révolutionne votre streaming.

À lire aussi

Le Firestick TV stick transforme n'importe quel écran en plateforme de divertissement. Pour en tirer le meilleur, vous avez [ ]
 · ·13 min

Le guide clair pour partager une connexion internet avec un PC, une tablette ou une console : méthode, sécurité, data et dépannage.
· ·8 min 
La qualité d'une navigation en ligne ne se devine pas ; elle se mesure. Pourtant, beaucoup hésitent encore à lancer un [ ]
· ·15 min 
Voici comment couper l'overlay Discord globalement ou par jeu, vérifier le raccourci et corriger les conflits qui gênent les FPS ou l'affichage.
· ·5 min 
Microsoft Intune devient utile quand le déploiement est cadré. Voici une méthode progressive pour sécuriser les appareils sans casser le quotidien des équipes.
· ·11 min 
Un message d'absence Teams utile ne se limite pas à un statut : il doit indiquer la période, le relais, l'urgence et rester cohérent avec Outlook.
· ·12 min Un recap net, des sorties a surveiller et nos meilleurs debriefs sans spam.
Aucun spam. Désinscription en un clic.
