Crawl
Le robot demande une URL, recupere la page et repere ce qu il peut explorer ensuite.


Un crawler web ne juge pas un site comme un lecteur humain. Il arrive par une URL, demande une page au serveur, lit ce qui lui est accessible, repere les liens, puis decide quoi explorer ensuite. Cette mecanique parait discrete, mais elle conditionne une partie essentielle du SEO : si un robot ne trouve pas une page, la comprend mal ou gaspille trop de temps sur des URLs inutiles, l'indexation devient plus fragile.
Le sujet merite donc mieux qu'une image de petit robot magique qui parcourt Internet. Un crawler est un programme d'exploration, avec des regles, des limites et des signaux techniques a respecter. Pour un site de contenu, un ecommerce, un media ou une application web, comprendre son fonctionnement aide a corriger les blocages avant qu'ils ne deviennent invisibles dans les resultats de recherche.
Imaginez un visiteur tres rapide, mais incapable de deviner une porte cachee. Cette image resume assez bien le fonctionnement d'un robot d'exploration.
Un crawler, aussi appele robot, spider ou bot d'exploration, est un logiciel qui visite automatiquement des pages web. Son role le plus connu consiste a alimenter les moteurs de recherche. Googlebot, Bingbot ou d'autres robots decouvrent des contenus, recuperent des ressources, analysent les signaux disponibles et transmettent ces informations aux systemes qui construiront l'index. Pour Morgan, c'est la base technique a comprendre avant de parler de positions SEO.
Il existe aussi des crawlers utilises pour d'autres usages : audit SEO, surveillance de liens morts, controle de prix, analyse de performance, archivage ou securite. Tous ne poursuivent pas le meme objectif. Certains respectent strictement les consignes du site, d'autres sont plus agressifs, et quelques robots malveillants cherchent surtout a aspirer des donnees ou tester des failles. Dans un audit, il faut donc distinguer le robot de moteur de recherche, le crawler d'outil SEO et le bot parasite.
Pour un responsable de site, l'enjeu principal reste simple : rendre les pages utiles faciles a decouvrir, et eviter de pousser les robots vers des zones sans valeur. Un crawler n'a pas besoin d'une architecture spectaculaire. Il a besoin d'une structure lisible, de liens coherents, de reponses serveur propres et d'indications qui ne se contredisent pas. C'est souvent moins glamour qu'un redesign, mais beaucoup plus mesurable.
Le SEO devient plus clair quand on separe ces etapes.
Le robot demande une URL, recupere la page et repere ce qu il peut explorer ensuite.
Le moteur decide si la page merite d entrer dans son index et sous quelle forme.
La page indexee est ensuite comparee aux autres resultats pour une requete donnee.
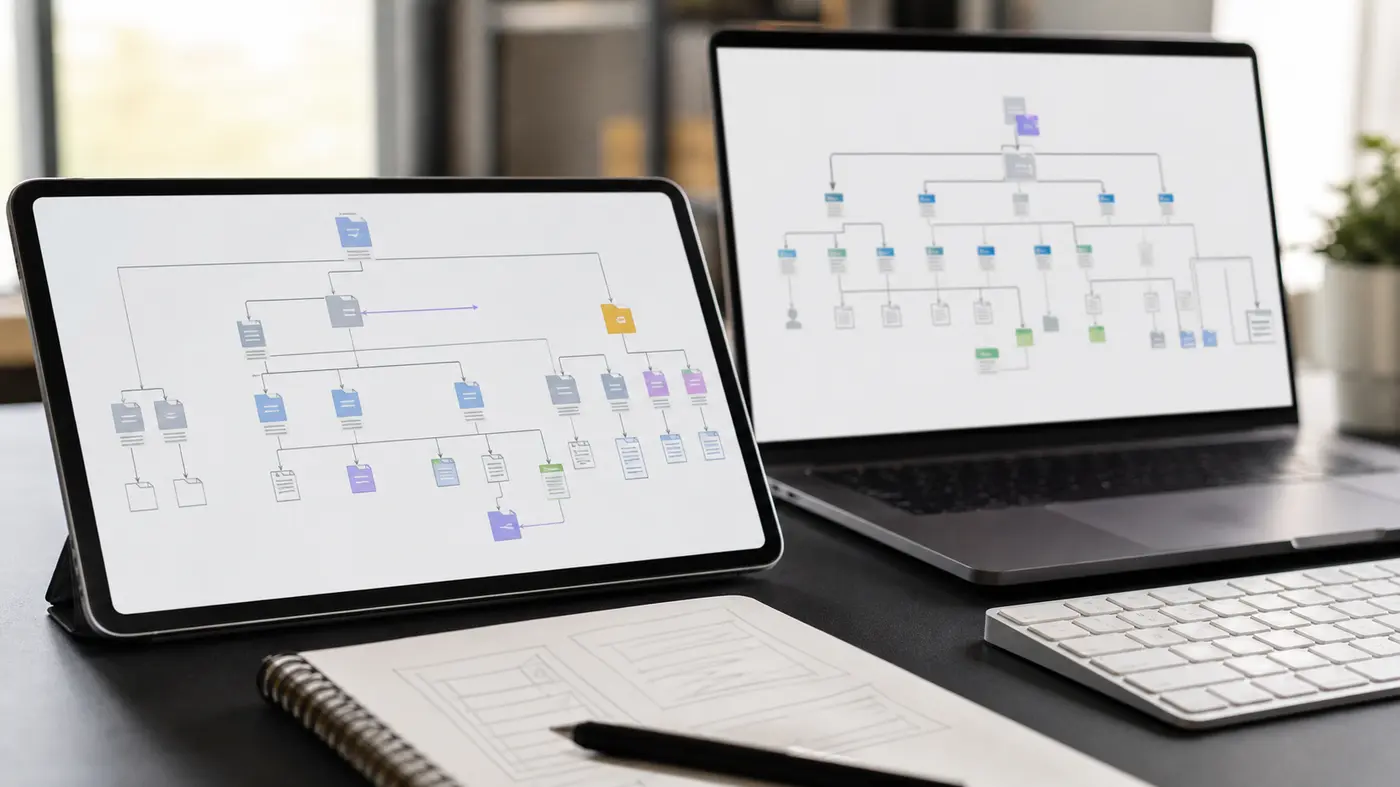
La decouverte commence rarement de zero. Elle repose sur une memoire du web, puis sur les chemins que chaque site laisse ouverts.
Un moteur possede deja des URLs connues, des liens observes ailleurs, des sitemaps soumis, des signaux historiques et parfois des flux issus de ses propres outils. Quand le robot arrive sur une page, il lit les liens presents dans le HTML, ajoute de nouvelles URLs a sa file d'exploration, puis arbitre selon la priorite, la qualite probable et la capacite du serveur a repondre. Cette file n'est donc jamais une simple liste chronologique.
Les liens internes jouent ici un role central. Une page accessible depuis le menu, une categorie, un fil d'Ariane ou un article proche a plus de chances d'etre decouverte qu'une page publiee sans aucun chemin interne. A l'inverse, une page orpheline peut exister dans le CMS, recevoir une URL valide et rester pourtant tres peu visible pour les robots.
Le sitemap XML complete cette logique. Il signale les URLs que le site considere importantes, notamment sur les gros sites, les contenus recents ou les pages peu liees. Mais il ne remplace pas une architecture saine. Si une URL figure dans le sitemap tout en etant bloquee, redirigee, canonicalisee vers une autre page ou absente de la navigation, le moteur recoit un message contradictoire.
La question utile n'est pas seulement : que voit l'internaute ? C'est aussi : que recoit le robot au bon moment ?
Le crawler commence par ce que le serveur lui renvoie. Un HTML propre, un titre coherent, des liens visibles, des ressources chargeables et une structure logique facilitent son travail. Les moteurs modernes savent traiter beaucoup de situations complexes, y compris du JavaScript, mais ce n'est pas une raison pour rendre toute l'information dependante d'un rendu lourd ou instable. Dans un audit, le HTML initial reste un excellent revelateur de robustesse.
Un complément utile : Bing Image Creator, autour de bing image creator, bien générer des visuels sans perdre le contrôle.
Le point critique se situe souvent entre ce que le visiteur voit et ce que le robot peut recuperer. Un menu injecte tardivement, une pagination chargee uniquement au clic, un contenu masque derriere un script casse ou une fiche produit sans lien HTML clair peut creer un ecart. Le lecteur pense que la page existe normalement ; le robot, lui, rencontre un contenu rendu en JavaScript trop tardif ou incomplet.
Les signaux de controle comptent aussi. Une balise meta robots en noindex, une balise canonique vers une autre URL, une redirection permanente ou un code 404 changent completement l'interpretation. Le crawler ne se contente pas de lire le texte : il lit le statut de la page dans l'ecosysteme technique du site.
Trois outils reviennent souvent dans les audits. Ils se ressemblent peu, et c'est justement la source de nombreuses erreurs de configuration.
Le fichier robots.txt indique aux robots les zones du site qu'ils peuvent ou ne peuvent pas explorer. Il est utile pour eviter de gaspiller du crawl sur des pages techniques, des filtres ou des chemins sans interet SEO. En revanche, il ne doit pas etre traite comme un coffre-fort. Une URL bloquee par robots.txt peut rester connue par d'autres signaux, et le fichier lui-meme est public. On l'utilise pour guider l'exploration, pas pour proteger un document confidentiel.
La balise meta robots fonctionne autrement. Placee sur une page accessible, elle peut demander au moteur de ne pas indexer cette page, ou de ne pas suivre certains liens selon les cas. Pour qu'un noindex soit pris en compte, le robot doit pouvoir consulter la page. Bloquer la meme page dans robots.txt tout en esperant que son noindex soit lu est donc une mauvaise combinaison.
Le sitemap, lui, sert a declarer les URLs importantes. Il doit etre propre, actualise et coherent avec l'etat reel du site. Une bonne pratique consiste a n'y garder que des pages indexables, repondant en 200, non canonicalisees ailleurs et utiles au lecteur. Un sitemap rempli d'anciennes redirections, de pages vides ou de doublons envoie un signal de maintenance faible.
Ces fichiers et balises n ont pas la meme fonction.
Encadrer le crawl
Utile pour limiter l exploration de zones sans valeur ou trop nombreuses.
Signaler les URLs utiles
Aide a la decouverte, mais ne compense pas une structure interne faible.
Piloter l indexation
Permet notamment de demander un noindex sur une page consultable.
Une page invisible n'est pas toujours une mauvaise page. Elle peut simplement etre mal exposee au chemin de crawl.
Quand une page ne remonte pas dans Google, le reflexe consiste souvent a incriminer le contenu. Parfois, le probleme est plus basique : le robot ne la trouve pas, ne peut pas la lire correctement ou recoit un signal qui lui demande de l'ignorer. Une page peut etre bien redigee et rester quasi invisible si elle est enfouie trop profondement ou si aucun lien interne ne la soutient. Le diagnostic doit donc commencer par l'acces, pas par la reecriture.
Les pages orphelines sont un cas frequent. Elles existent dans le CMS, parfois meme dans le sitemap, mais elles ne sont reliees a aucune zone vivante du site. Pour un crawler, cela ressemble a une piece sans porte. Il peut finir par la trouver, mais elle parait moins centrale qu'une page accessible depuis une categorie, un guide ou une navigation logique.
Les contenus dupliques posent un autre probleme. Si plusieurs URLs affichent presque la meme page, le moteur doit choisir. Il peut retenir une version qui n'est pas celle que vous attendiez, ou diluer ses visites entre des variantes inutiles. Les filtres, parametres, tags, archives et pages de recherche interne peuvent ainsi consommer beaucoup d'exploration sans apporter de vraie valeur.
| Symptome | Cause probable | Priorite |
|---|---|---|
| Page jamais vue dans les outils | Aucun lien interne, sitemap absent ou URL bloquee | Haute |
| Page exploree mais non indexee | Qualite faible, duplication, canonique ou noindex | Haute |
| Crawl massif sur filtres | Facettes et parametres non controles | Moyenne |
| Robot bloque sur redirections | Chaines, boucles ou anciennes URLs mal nettoyees | Haute |
| Contenu principal absent | Rendu JavaScript incomplet ou ressources bloquees | Haute |
Le crawl budget devient visible quand le site grossit. Sur un blog simple, il reste souvent discret; sur un catalogue, il se paie vite.
Le crawl budget designe, de maniere pratique, la capacite qu'un moteur consacre a explorer un site sur une periode donnee. Sur un petit site propre, ce n'est pas toujours un sujet bloquant. Sur un gros catalogue, un media ancien, un forum, un ecommerce ou un site rempli de parametres, il devient beaucoup plus concret : chaque visite gaspillee sur une URL inutile retarde l'exploration des pages importantes.
La qualite technique influence cette capacite. Un serveur lent, des erreurs 5xx, des timeouts, des pages tres lourdes ou des redirections en chaine rendent l'exploration plus couteuse. Le moteur essaie generalement de ne pas surcharger un site. Si les reponses sont mauvaises, il peut ralentir. Ce n'est pas une penalite morale, mais une contrainte d'efficacite. La stabilite technique devient alors un levier SEO indirect.
Les codes HTTP doivent donc raconter la bonne histoire. Une page disponible repond en 200. Une page supprimee durablement peut repondre en 410 ou 404 selon le cas. Une page deplacee proprement redirige vers une destination pertinente, sans chaine interminable. Une erreur serveur reste exceptionnelle et corrigee vite. Plus ces signaux sont nets, plus le crawler comprend ce qu'il doit faire.
Avant de chercher une theorie compliquee, verifiez ces points.
Avant de lancer un outil, fixez la cible. Sinon, l'audit produit une longue liste d'URLs sans priorite metier.
Un bon audit commence par une question simple : quelles pages voulez-vous vraiment faire explorer et indexer ? Sans cette priorite, on se perd dans des milliers d'URLs, de filtres, de tags et d'anciennes pages. Pour un media ou un blog, les pages importantes sont souvent les articles durables, les categories utiles et quelques dossiers. Pour un ecommerce, ce sont les categories, produits strategiques, guides et pages transactionnelles.
Ensuite, il faut comparer trois vues. La premiere est la vue CMS : les pages que vous pensez avoir publiees. La deuxieme est la vue crawler SEO : les URLs qu'un outil arrive a decouvrir depuis la page d'accueil. La troisieme est la vue moteur : les donnees Search Console, les sitemaps, les erreurs et les requetes. Les ecarts entre ces vues revelent souvent la vraie dette technique.
Les logs serveur ajoutent une couche plus avancee. Ils montrent quelles URLs les robots demandent vraiment, a quelle frequence et avec quels codes de reponse. C'est particulierement utile sur les gros sites, parce qu'un crawl logiciel ne reproduit pas toujours le comportement exact de Googlebot ou Bingbot. Les logs serveur permettent de voir si les robots passent leur temps sur les bonnes zones.
Ils indiquent que le crawler ne voit pas le site comme vous.
Les pages importantes demandent-elles plus de trois ou quatre clics ?
Impact décision : Renforcer categories, hubs et liens contextuels.
Le sitemap contient-il des URLs redirigees, bloquees ou non indexables ?
Impact décision : Nettoyer le sitemap avant de chercher d autres leviers.
La page declare-t-elle une autre URL canonique sans raison claire ?
Impact décision : Clarifier la version principale a indexer.
Les robots visitent-ils surtout des filtres, tags ou parametres ?
Impact décision : Encadrer ces zones et renforcer les pages utiles.
Ne commencez pas par tout crawler. Commencez par ce qui doit vraiment gagner en visibilite.
Commencez par les pages qui comptent. Choisissez une dizaine d'URLs strategiques : articles qui doivent attirer du trafic, categories fortes, pages produits ou dossiers evergreen. Pour chacune, verifiez si elle est dans le sitemap, accessible en quelques clics, reliee par des pages proches, indexable, rapide et exempte de signaux contradictoires. Ce petit echantillon suffit souvent a trouver les defauts repandus sur le reste du site. Il donne aussi une priorite claire aux corrections.
Travaillez ensuite par familles de problemes. Corriger une redirection isolee aide peu si tout le site conserve des chaines anciennes. Ajouter un lien vers une page orpheline aide peu si les nouvelles publications ne sont jamais rattachees a une categorie vivante. Le bon reflexe consiste a transformer chaque anomalie en regle : modele de page, gabarit, sitemap, navigation, canonique ou processus de publication.
Enfin, surveillez apres correction. Un crawler ne change pas instantanement la perception du site. Les moteurs doivent revisiter, retraiter et comparer les nouvelles informations. Il faut donc suivre les erreurs, les pages explorees, l'indexation et les requetes sur plusieurs semaines. La priorite n'est pas d'obtenir une perfection theorique, mais de creer un plan de retour arriere, une maintenance durable et une lecture simple pour l'equipe qui reprendra le site plus tard.
Un crawler diagnostique. Il ne decide pas la strategie, et c'est une limite a garder en tete.
Un crawler ne remplace pas une strategie editoriale. Il peut montrer qu'une page est difficile a atteindre, mais il ne prouve pas que le contenu repond vraiment a l'intention de recherche. Il peut reveler des doublons, mais il ne decide pas a votre place quelle page doit porter l'angle principal. Il peut compter les liens, mais il ne sait pas toujours si le lien aide vraiment un lecteur.
Il faut donc utiliser l'audit de crawl comme un outil de diagnostic, pas comme une liste aveugle d'ordres a executer. Une page profonde peut etre volontairement secondaire. Une archive peut etre utile a l'utilisateur sans devoir etre indexee. Une redirection peut etre acceptable si elle preserve un ancien trafic. La bonne question reste : est-ce que cette decision aide le lecteur, le moteur et la maintenance du site en meme temps ?
Pour un site en croissance, la meilleure discipline est souvent la plus simple : publier moins de pages faibles, mieux relier les contenus utiles, garder un sitemap propre et surveiller les erreurs avant qu'elles ne s'empilent. Le crawler n'a pas besoin qu'on lui parle en jargon. Il a besoin d'un site clair, rapide, coherent et maintenu.
La priorite est le chemin, pas le jargon. Si le chemin est confus, le reste devient plus fragile.
Comprendre les crawlers revient a comprendre le chemin que votre site propose aux moteurs. Un bon contenu peut rester discret s'il est isole, contradictoire ou techniquement difficile a lire. A l'inverse, une structure propre aide les robots a consacrer plus d'attention aux pages qui servent vraiment vos lecteurs.
Avant d'ajouter de nouveaux articles ou de chercher une astuce SEO, verifiez donc le socle : la zone DNS et le serveur repondent correctement, les pages utiles sont liees, le sitemap reste propre, les consignes d'indexation sont coherentes et les erreurs ne s'accumulent pas. C'est moins spectaculaire qu'une promesse de ranking rapide, mais c'est ce qui rend le SEO durable. Une fois ce socle propre, chaque nouveau contenu part avec de meilleures chances.

À lire aussi

Le Firestick TV stick transforme n'importe quel écran en plateforme de divertissement. Pour en tirer le meilleur, vous avez [ ]
· ·13 min 
Le guide clair pour partager une connexion internet avec un PC, une tablette ou une console : méthode, sécurité, data et dépannage.
 · ·8 min

La qualité d'une navigation en ligne ne se devine pas ; elle se mesure. Pourtant, beaucoup hésitent encore à lancer un [ ]
· ·15 min 
Voici comment couper l'overlay Discord globalement ou par jeu, vérifier le raccourci et corriger les conflits qui gênent les FPS ou l'affichage.
· ·5 min 
Microsoft Intune devient utile quand le déploiement est cadré. Voici une méthode progressive pour sécuriser les appareils sans casser le quotidien des équipes.
· ·11 min 
Un message d'absence Teams utile ne se limite pas à un statut : il doit indiquer la période, le relais, l'urgence et rester cohérent avec Outlook.
· ·12 min Un recap net, des sorties a surveiller et nos meilleurs debriefs sans spam.
Aucun spam. Désinscription en un clic.
